

Когда и зачем бизнесу переносить AI в собственную инфраструктуру
Разбираем, в каких случаях достаточно внешних AI‑сервисов, а когда бизнесу имеет смысл переносить LLM в собственную инфраструктуру. На примере проекта для телеком‑компании из региона MENA.
Как понять, что ChatGPT уже недостаточно
На старте внедрение LLM обычно даёт быстрый эффект. Компании подключают ChatGPT и сразу получают результат: тексты готовятся быстрее, ответы становятся структурированнее, аналитика собирается проще. Дополнительно появляются автоматизации через Make или N8N, простые AI‑сценарии начинают закрывать отдельные задачи.
Этот подход работает, пока нагрузка и требования остаются ограниченными.
С ростом бизнеса ситуация меняется. LLM начинает использоваться не точечно, а в ежедневной работе. В процессах появляются внутренние документы, клиентские данные, операционные показатели. Параллельно растёт количество пользователей, интеграций и сценариев.
В этот момент возникают новые требования: контроль доступа, стабильная работа без сбоев, интеграция с внутренними системами и понятная экономика использования. Внешние сервисы начинают ограничивать скорость внедрения и масштабирование.
С такой задачей к нам обратилась телеком‑компания из MENA. Их цель была не протестировать AI, а выстроить внутри компании устойчивую платформу для работы с моделями, данными и сценариями использования.




- Россияне впервые за восемь лет снизили зарплатные ожидания
- Мировой тренд: ИТ‑специалисты теряют интерес к работе из‑за внедрения ИИ
- Бизнес в России перестает удерживать увольняющихся сотрудников
- Дата‑центр Яндекса в Калуге поврежден из‑за атаки БПЛА
- Яндекс Маркет завершил реферальную программу для селлеров
- Сумма штрафов бизнесу за нарушения при найме мигрантов выросла на 22% за год
Что такое on‑prem LLM
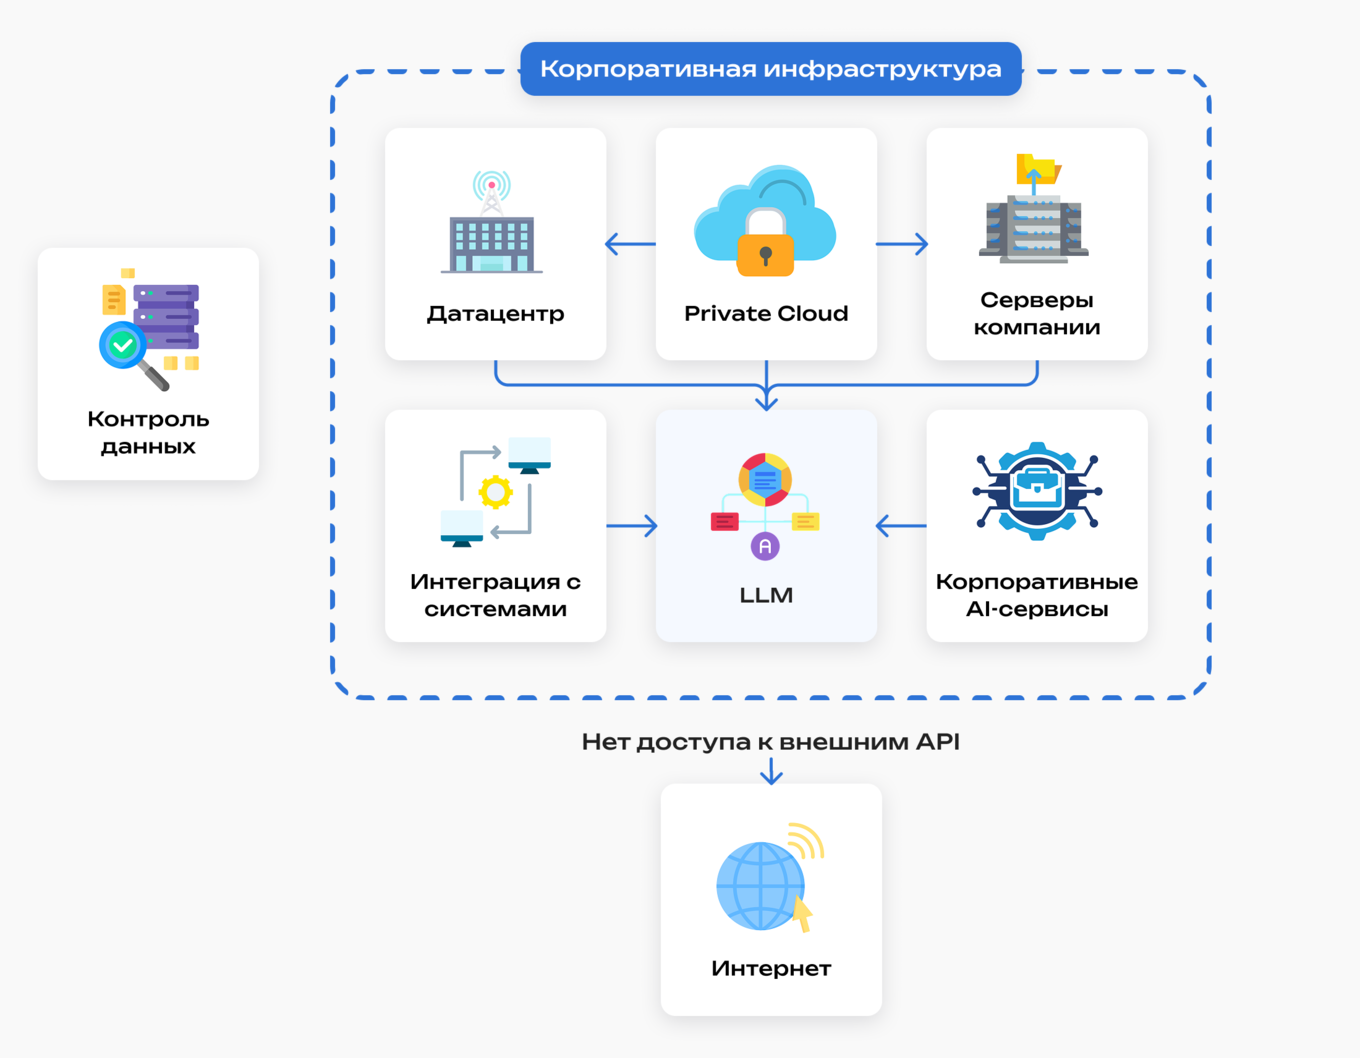
On‑premise — это формат, при котором AI‑платформа работает внутри инфраструктуры компании: в собственном датацентре, private cloud или colocation. Модель не обращается к внешним API и не передаёт данные за пределы корпоративного контура.
Такой подход позволяет:
- контролировать, какие данные используются и куда они передаются;
- управлять доступами и ролями пользователей;
- встроить модель в процессы компании и интегрировать с внутренними системами;
- использовать AI как постоянный сервис, а не как отдельный инструмент.
Когда стоит рассматривать переход на on‑prem
Есть несколько ситуаций, в которых внешний LLM перестаёт быть удобным решением.
Работа с внутренними данными. Если в AI‑сценариях используются внутренние документы, клиентская информация или операционные показатели, возникает вопрос безопасности. В большинстве компаний такие данные нельзя передавать во внешние сервисы.
Это приводит к ограничениям: часть сценариев нельзя запускать, а внедрение AI замедляется из‑за согласований с безопасностью и юристами.
Встраивание AI в процессы. Когда модель нужно использовать внутри продуктов или внутренних систем, появляются требования к доступам, ролям и источникам данных. Модель должна работать в интерфейсе сотрудника, получать данные из корпоративных систем и возвращать результат обратно.
Во внешних сервисах такие сценарии ограничены. Это увеличивает риски, усложняет контроль и снижает доверие со стороны команд.
Рост затрат. На небольших объёмах использование API выглядит выгодным. При росте нагрузки расходы на токены увеличиваются и могут достигать десятков тысяч долларов в месяц.
В этой ситуации бизнесу важно контролировать бюджет и прогнозировать затраты. Собственная инфраструктура позволяет это сделать.

В каких компаниях это актуально
Переход на on‑prem чаще всего рассматривают компании, в которых AI становится частью операционной деятельности:
- компании с высокими требованиями к безопасности и комплаенсу;
- бизнес с большим объёмом внутренних данных;
- контакт‑центры и массовый клиентский сервис;
- компании с несколькими продуктами и командами;
- бизнес с планируемым ростом использования AI.
Как проходит внедрение
В проекте с телеком‑компанией задача заключалась не в развертывании кластера как такового, а в создании платформы, которую можно использовать и развивать внутри компании.
Работа строилась поэтапно. Сначала развернули базовую инфраструктуру, затем расширили её и проверили на реальных сценариях обучения и инференса.
Основные этапы
Проект начинается с фиксации целей и требований на уровне бизнес‑процессов. После этого проектируется архитектура: вычислительные мощности, работа с данными, безопасность и эксплуатация.
Далее платформа разворачивается внутри инфраструктуры компании, подключаются интеграции и настраивается хранение данных. Параллельно вводятся единые правила работы с данными и доступами.
После этого настраиваются метрики, логирование и мониторинг. Система тестируется на реальных сценариях, включая обучение моделей и работу под нагрузкой.
На финальном этапе платформа передаётся в эксплуатацию с документацией и регламентами.
Как выглядит техническое решение
Ключевые параметры решения на проекте
Инфраструктура была развёрнута в два этапа. На первом этапе использовались два DGX‑сервера с Kubernetes и двумя management‑ноды. Общая мощность составила 16 GPU A100 — по 8 GPU на каждую вычислительную ноду.
На втором этапе кластер расширили до трёх DGX A100, добавив дополнительные вычислительные ресурсы.
Для хранения данных использовалось общее хранилище на базе Lustre‑backed DDN объёмом 100 ТБ. Все датасеты и артефакты обучения размещались в едином пространстве.
Мониторинг и наблюдаемость реализованы через Prometheus и Grafana, централизованные логи — через OpenSearch.
Система была протестирована на реальных сценариях. Для обучения использовались распределённые задачи на нескольких нодах. Объём данных составлял 20 ГБ, после обработки — около 10 ГБ.
Для инференса использовалась модель Llama 3 70B Instruct. В тестах выполнялось от 100 до 200 запросов, скорость обработки составляла от 300 до 700 токенов в секунду с контролем ключевых метрик.
Как бизнес использует платформу дальше
После внедрения платформа становится частью внутренней инфраструктуры и используется в ежедневной работе.
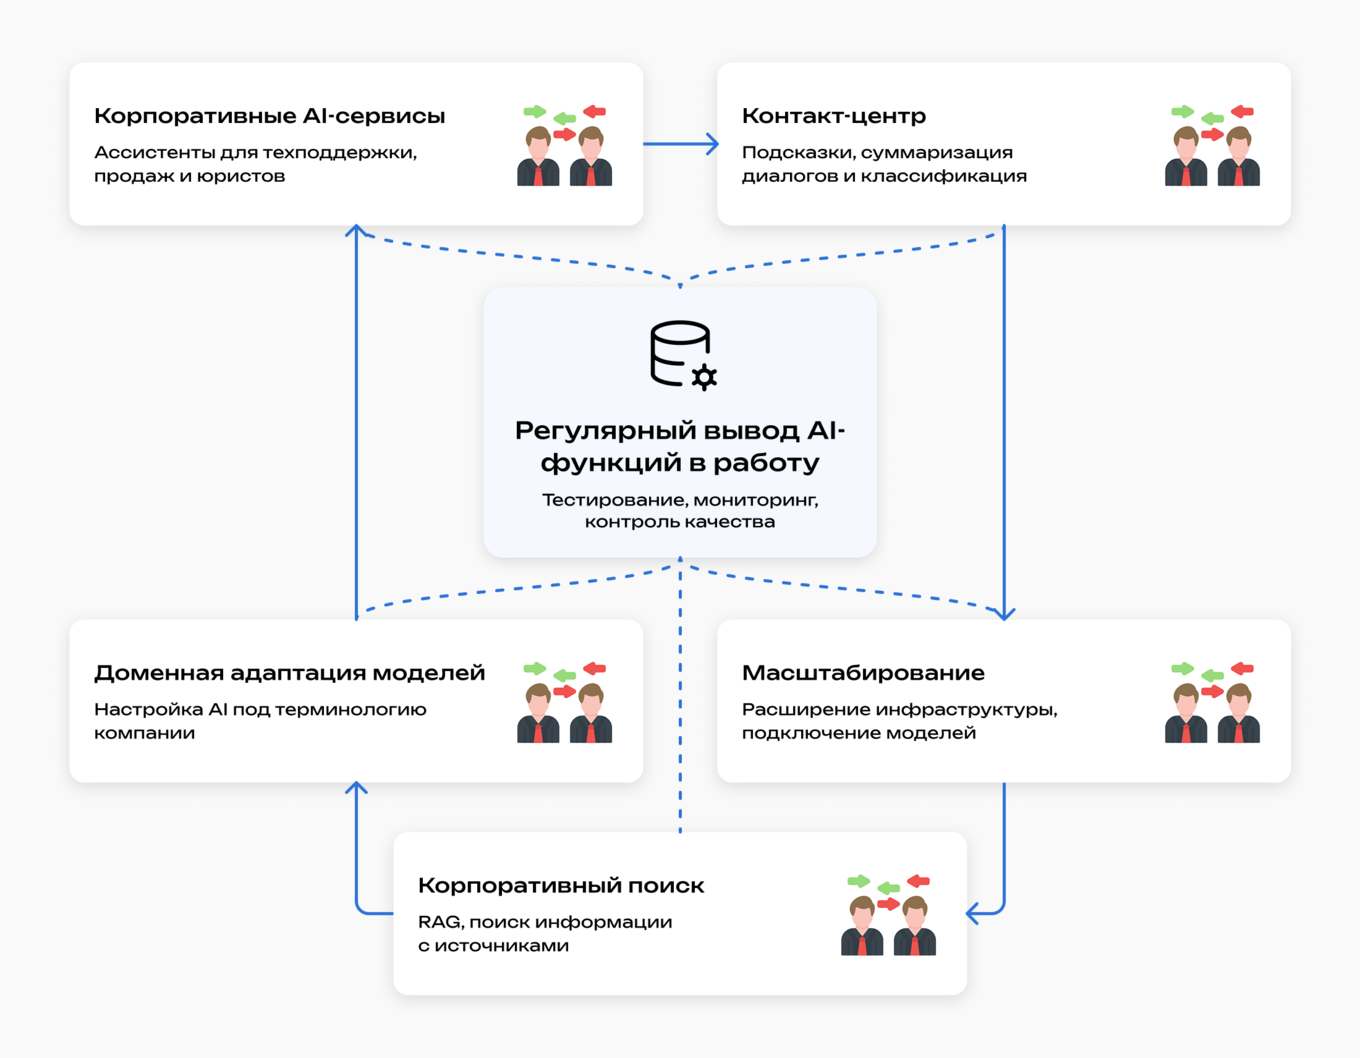
Компании разворачивают корпоративные AI‑сервисы для сотрудников — ассистенты помогают в техподдержке, продажах, операционных и юридических задачах, используя внутренние базы знаний.
В контакт‑центрах появляются подсказки операторам, автоматическая суммаризация диалогов и классификация обращений, что ускоряет обработку запросов.
Формируется единая система корпоративного поиска на основе RAG, которая позволяет находить информацию в документах и получать ответы с указанием источников.
Далее компании переходят к донастройке моделей под собственную терминологию и процессы. Это повышает качество ответов и точность работы.
По мере роста нагрузки платформа масштабируется: добавляются новые модели, увеличивается количество пользователей, расширяется инфраструктура.
Параллельно выстраивается процесс регулярного вывода AI‑функций в прод с тестированием, мониторингом и контролем качества.
Что получает бизнес в итоге
В результате компания получает не отдельные AI‑инструменты, а управляемую систему.
AI‑сценарии можно добавлять постепенно без изменения базовой архитектуры. Появляется прозрачность: можно отслеживать нагрузку, выявлять узкие места и контролировать работу системы.
Расходы становятся прогнозируемыми, так как инфраструктура контролируется внутри компании.
Такой подход позволяет использовать AI как часть операционной модели, а не как эксперимент.











