

Как устроен ИИ‑анализ звонков и на что смотреть при выборе подрядчика
Разговор о внедрении речевой аналитики почти всегда упирается в два вопроса. Служба безопасности спрашивает, куда уйдут записи разговоров с клиентами, а руководитель отдела продаж — можно ли опираться на то, что нейросеть напишет в отчёте. Чтобы ответить, нужно знать, как устроен маршрут данных.
Разбираем, из чего складывается безопасная схема анализа звонков и по каким признакам её оценивать на этапе выбора подрядчика. Свой опыт в сервисе ИИ‑аналитики и автоматизации продаж «Аихаб» приводим как один из возможных вариантов реализации. Для дочитавших бонус — чек‑лист вопросов, которые имеет смысл задать до подписания договора.
Сколько стоит утечка записей разговоров
До мая 2025 года вопрос «где хранятся записи» относился скорее к области репутации. С 30 мая 2025 года действуют поправки в статью 13.11 КоАП, введённые Федеральным законом от 30.11.2024 № 420‑ФЗ: размер штрафа за утечку персональных данных привязан к объёму инцидента. Для юридического лица это от 3 до 5 млн рублей при утечке данных от 1 до 10 тысяч человек и от 10 до 15 млн рублей, если пострадали более 100 тысяч. Для специальных категорий данных и биометрии предусмотрен отдельный состав — до 20 млн рублей.
Повторная утечка наказывается оборотным штрафом: от 1 до 3% совокупной годовой выручки, но не менее 20 млн и не более 500 млн рублей. Отдельно, до 3 млн рублей, наказывается неуведомление Роскомнадзора о факте утечки.
Записи разговоров с клиентами содержат имена, телефоны, иногда адреса и сведения о заказах, то есть попадают под общую шкалу. Для компании, которая отдаёт подрядчику несколько тысяч звонков в месяц, это переводит вопрос об инфраструктуре из формальной плоскости в финансовую: ответственность оператора персональных данных остаётся на заказчике независимо от того, кто фактически обрабатывает записи.




- Россияне впервые за восемь лет снизили зарплатные ожидания
- Мировой тренд: ИТ‑специалисты теряют интерес к работе из‑за внедрения ИИ
- Бизнес в России перестает удерживать увольняющихся сотрудников
- Дата‑центр Яндекса в Калуге поврежден из‑за атаки БПЛА
- Яндекс Маркет завершил реферальную программу для селлеров
- Сумма штрафов бизнесу за нарушения при найме мигрантов выросла на 22% за год
Какие модели можно использовать для анализа звонков
Зарубежные нейросети применять не запрещено. Ограничение касается не самих моделей, а того, что в них отправляется. Передача персональных данных на серверы за пределами России подпадает под статью 12 закона от 27.07.2006 № 152‑ФЗ, которая относит такую передачу к трансграничной и устанавливает для неё отдельный порядок: уведомление Роскомнадзора до начала передачи, получение согласия субъекта именно на трансграничную передачу и оценку условий защиты данных в стране получателя.
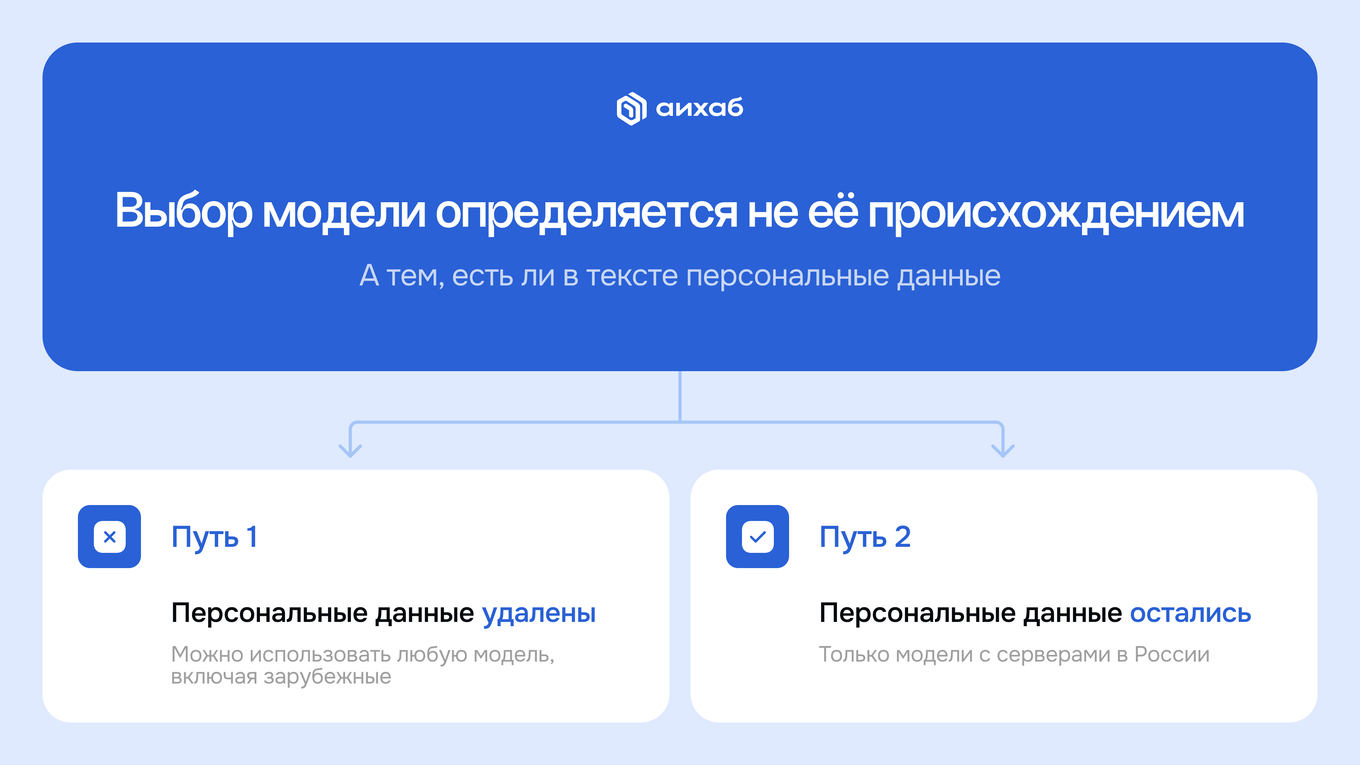
Отсюда две развилки на выбор. Персональными данными закон называет любые сведения, относящиеся к прямо или косвенно определённому лицу, — соответственно, расшифровка, из которой удалены имена, телефоны, адреса и другие идентифицирующие фрагменты, этому определению уже не отвечает, и выбор модели для её разбора ничем не ограничен. Если расшифровка передаётся как есть, круг сужается до моделей, чьи серверы физически расположены в России, — в первую очередь это YandexGPT и GigaChat.
Это и есть главный технический вопрос к подрядчику: не какая у него модель, а в какой из двух режимов он вас ставит и есть ли выбор. В «Аихаб» мы сделали выбор модели настраиваемым — часть клиентов работает через Claude на обезличенных расшифровках, часть принципиально остаётся на YandexGPT с исходным текстом.
Где может происходить обезличивание
Обезличивание — не бинарная опция «есть или нет», а вопрос о том, в чьём контуре текст с персональными данными существует в открытом виде и кто за этот контур отвечает. Отсюда четыре схемы, которыми в принципе исчерпывается рынок ИИ‑аналитики звонков.
Первая схема даёт максимальную свободу в выборе модели, но требует доверия к подрядчику: текст с персональными данными какое‑то время живёт в его инфраструктуре. Проверять здесь стоит не факт обезличивания, а то, работает ли обезличивающий модуль локально или сам обращается к внешнему сервису — во втором случае персональные данные всё равно покидают периметр.
В «Аихаб» эту задачу решает собственная модель на российском сервере, которая не делает внешних запросов вообще: расшифровка приходит к ней внутри контура и там же остаётся.
Вторая схема самая простая по организации и снимает вопрос о качестве обезличивания, поскольку текст не меняется. Плата за это — ограниченный выбор моделей и то, что данные всё равно обрабатываются в чужом облаке, пусть и российском.
Третья подходит компаниям, у которых процесс уже выстроен: они сами вычищают чувствительные фрагменты и передают подрядчику готовый текст. Персональные данные при этом не покидают их периметр вообще, но и качество обезличивания становится их зоной ответственности — подрядчик работает с тем, что получил, и проверить, не удалено ли лишнее, на своей стороне уже не может.
Четвёртая схема нужна там, где риск связан не с персональными данными клиентов, а с содержанием разговоров. Ни один разработчик публичной модели не раскрывает полностью, что именно его сервис сохраняет из входящих запросов и как это использует; пользовательские соглашения написаны широко и пересматриваются часто.
Если компания не хочет, чтобы скрипты продаж, ценовая логика и отработка возражений вообще выходили за периметр, модель разворачивается локально: она дообучается на данных компании, но всё остаётся внутри.


Из чего состоит безопасный маршрут звонка
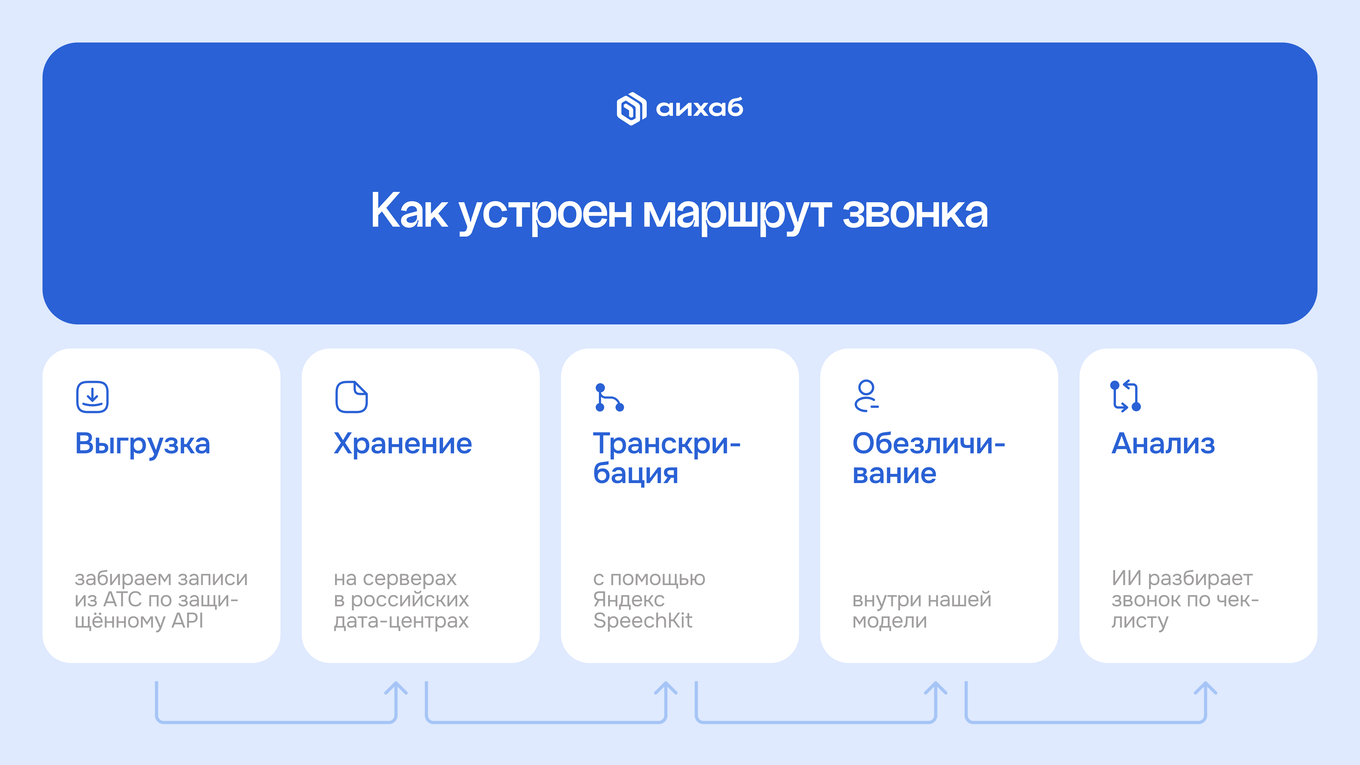
Выбор модели — одна точка в цепочке, а звонок проходит минимум пять. Поэтому проверять нужно весь путь данных.
Начинается всё с выгрузки. Записи забираются из виртуальной АТС клиента через API по защищённому каналу; если разбираются переписки, шаг тот же, только вместо аудио сразу приходит текст. Дальше записи ложатся в хранилище — и здесь стоит спросить про документы, которые подтверждают, что серверы физически находятся в России.
Мы размещаем данные в российских дата‑центрах у провайдера, который такие документы предоставляет, и отдельно фиксируем разделение зон ответственности: площадка отвечает за инфраструктуру, а подрядчик — за настройку системы, разграничение доступа и порядок обработки.
Третий шаг — транскрибация. Чтобы перевести аудио в текст, потребуется помощь внешнего сервиса. Его расположение также стоит проверить. Мы используем Яндекс SpeechKit, запись передаётся туда по защищённому API, серверы расположены в России.
Четвёртый шаг — обезличивание, если оно предусмотрено выбранной схемой.
Пятый — из текста собирается промпт с чек‑листом клиента, уходит в выбранную модель по шифрованному каналу, ответ возвращается и ложится в базу. На этих данных уже строятся отчёты и дашборды для отдела продаж.
От чего зависит качество ИИ‑анализа
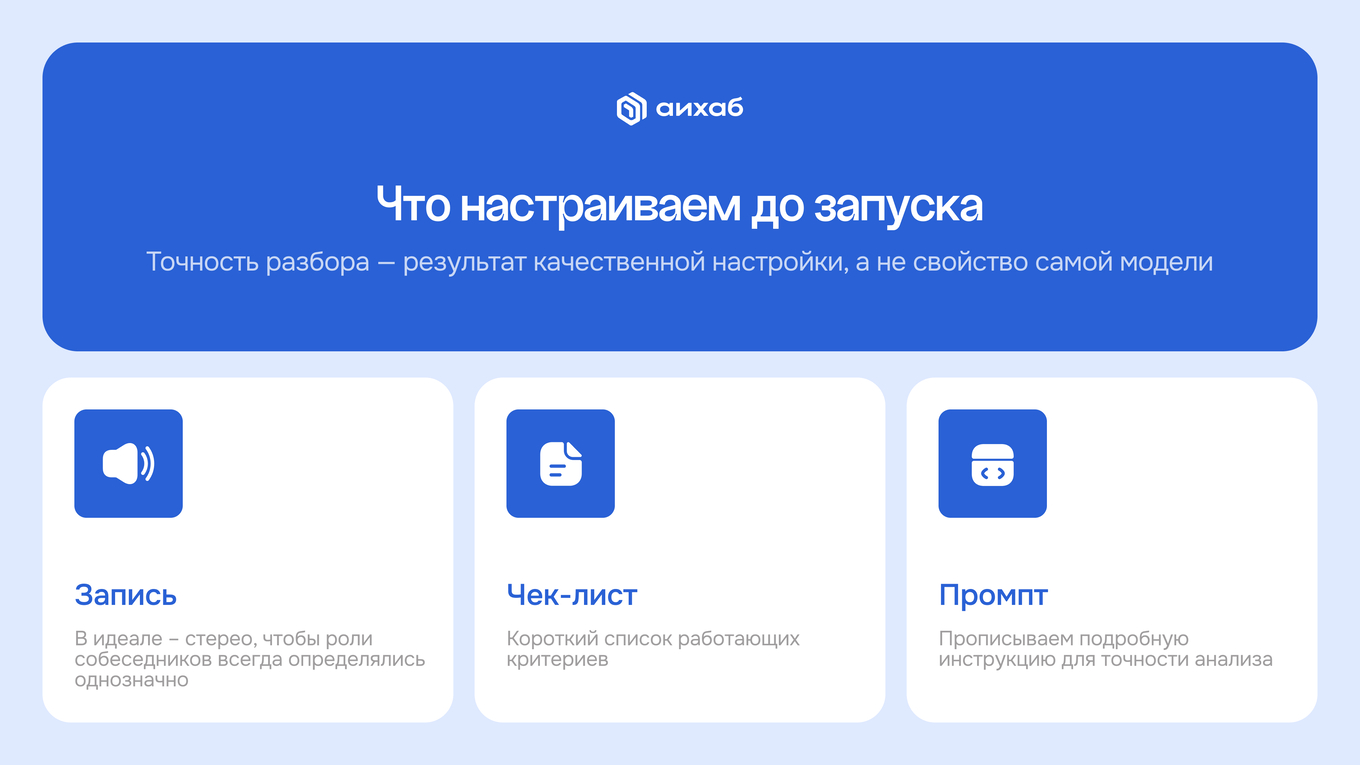
Точность отчёта — не свойство модели, а результат настройки. Нейросеть работает с тем, что ей дали: с записью на входе, со списком критериев и с самой инструкцией. На каждом из этих трёх участков точность можно либо потерять, либо обеспечить, и все три стоит обсудить с подрядчиком до старта.
Первое по важности — формат записи. Когда звонок пишется в моно, голоса обоих собеседников идут одним каналом, и алгоритму приходится определять говорящего по косвенным признакам. В стереозаписи менеджер и клиент разведены по разным каналам, роли определяются однозначно, и анализ звонков нейросетью получается более точным. Это настройка на стороне виртуальной АТС, а не сервиса аналитики.
Второе — объём чек‑листа. У модели ограниченное контекстное окно: короткий список работающих критериев она отрабатывает точнее, чем раздутый на 30 пунктов с дублями. Пересборка чек‑листа перед запуском — нормальная часть внедрения, а не признак того, что что‑то пошло не так; заодно компания наводит порядок в собственной системе оценки продаж. Мы такую пересборку проводим вместе с клиентом на старте.
Третье — формулировка промпта. Модель понимает инструкцию буквально: попроси тридцать оценок по звонку из пяти реплик — получишь тридцать, нехватка данных её не остановит. Рабочий промпт поэтому содержит жёсткие ограничения: разрешение ответить «в разговоре нет информации по этому пункту», прямой запрет достраивать недостающее и заранее заданное поведение на пограничных случаях — коротких звонках, нетипичных записях, разговорах не по теме. Формулировки промпта имеет смысл запросить и прочитать: по ним видно, заложена ли в систему возможность ответить «не знаю».
Настройка на этом не заканчивается, и это четвёртый критерий — уже не к системе, а к подрядчику. Неверно разобранный звонок — материал для доработки промпта, а не повод спорить об оценке; ошибка обезличивания, когда название компании принято за имя человека, правится в модели. Систему, которую нельзя поправить после запуска, вы получаете застывшей на качестве первого дня.
Что спросить у подрядчика, прежде чем подписывать договор
Пять вопросов имеет смысл задать любому сервису речевой аналитики:
- Где физически хранятся записи и расшифровки и какими документами это подтверждается?
- Какие внешние сервисы участвуют в обработке — транскрибация, модель, хранилище — и где расположены их серверы?
- Что происходит с персональными данными перед отправкой в модель и есть ли выбор схемы?
- По каким каналам данные передаются между этапами?
- Что происходит после того, как заказчик показал неверно разобранный звонок?
Первые четыре показывают, выдержит ли схема проверку безопасников, пятый — останется ли система пригодной через полгода.
Ответственность оператора персональных данных при этом остаётся на заказчике, поэтому выбранную схему имеет смысл согласовать с тем, кто в компании отвечает за организацию обработки персональных данных, — статья 18.1 закона № 152‑ФЗ обязывает оператора назначить такого сотрудника.











