

Disaster Recovery Plan (DRP): гайд по внедрению плана аварийного восстановления

Бизнес сильно зависит от ИТ‑инфраструктуры: через неё проходят платежи, на ней работают внутренние сервисы, хранятся данные клиентов и запускаются ключевые бизнес‑процессы. Если в дата‑центре случится авария, в магазинах перестают проходить оплаты, изменения в CRM не фиксируются, а сотрудники просто сидят без работы.
Ущерб может достигать миллионов рублей в час, а при отсутствии бэкапов важные данные для бизнеса иногда теряются полностью. В таких ситуациях нужно реагировать быстро, чтобы бизнес потерял как можно меньше. На эти случаи готовят специальный план аварийного восстановления, DRP.
Что такое Disaster Recovery Plan
Disaster Recovery Plan — это план аварийного восстановления ИТ‑инфраструктуры. Ещё его называют DR‑план. Это пошаговая инструкция, которая учитывает разные сценарии чрезвычайных ситуаций. Для каждой из них прописаны конкретные действия, порядок сохранения бэкапов, распределены ответственные и роли сотрудников. Такой план нужен, чтобы как можно скорее вернуть в работу сервисы компании, которые вышли из строя, и предотвратить повреждение или потерю данных.
Хороший Disaster Recovery Plan разрабатывается для нескольких типов угроз.
Технические сбои: выход из строя дисков (HDD/SSD), повреждение RAID, сбой контроллера или других устройств. Иногда из‑за аппаратных проблем на стороне провайдера могут отказать все сервисы компании разом, если они не держатся на распределённой инфраструктуре.
Киберинциденты: ransomware‑вирусы, взломы корпоративных аккаунтов, утечки данных или их удаление злоумышленниками. В число киберугроз также входят DDOS‑атаки, которые могут парализовать работу ИТ‑сервисов для клиентов и сотрудников.
Специалисты IBM утверждают, что киберугрозы стали одной из главной причин создания плана аварийного восстановления. Ранее ИТ‑инфраструктуру готовили к ЧС внешнего характера, но всё чаще команды безопасности сосредотачиваются на хакерских атаках.
Человеческий фактор: случайное удаление данных или их перезапись, ошибки оператора. Особенно часто встречаются в компаниях, где только зарождается инфраструктура безопасности — когда доступы участников почти ничем не ограничены.
Физические происшествия: перебои питания, пожары, затопления, стихийные бедствия. Иногда для аварии даже не требуется чрезвычайного происшествия — сервер просто может выйти из строя из‑за сильной жары и неисправности кондиционеров. Угрозы инфраструктуре возникают с разной вероятностью, но любая из них может стать критической.
Стопроцентно защитить ИТ‑инфраструктуру невозможно — не всегда можно учесть падающее дерево, удары молний и невнимательность стажёра из ИТ‑отдела. Но такие решения могут спасти компанию от больших издержек при авариях.




- В России резко подорожали товары для сна, но спрос на них растет
- С марта 2027 года табачные магазины будут лишать лицензий за продажу сигарет детям
- Минцифры готовит единые правила включения сайтов в белый список
- ПВЗ хотят облагать налогом на имущество по кадастровой стоимости
- Wildberries запустил передвижные пункты выдачи
- Авито Работа запустила страницы брендов для бизнеса
Какие задачи решает план аварийного восстановления
План восстановления сохраняет бизнесу деньги и время: иногда экономия может достигать сотен тысяч в минуту. Эффект достигается несколькими путями.
Минимизируется простой. Главная цель DR‑плана — восстановление систем в кратчайший срок. Из‑за быстрого реагирования компания не теряет продажи, сотрудники продолжают работу, а бизнес не платит штрафы за нарушение SLA и компенсации клиентам.
Сохраняются данные. Если предусмотрены резервные копии и порядок их восстановления, компания не теряет клиентскую базу, договоры, финансовые документы и базы знаний. Это особенно важно, если бизнес подвергся кибератаке — можно изолировать злоумышленника и восстановить систему.
Назначаются ответственные. Когда плана нет, во время аварии компания погружается в хаос. Специалисты не могут сориентироваться, за что хвататься — и время простоя увеличивается. При наличии DR у команды есть чёткий план действий, который ускоряет принятие решений.
Disaster Recovery Plan поддерживает критически важные процессы внутри компании. Из‑за быстрого восстановления производственные цепочки не разрываются, потому что поломка инфраструктуры не парализует работу бизнеса.
Какому бизнесу нужен DR‑план
Наиболее уязвимые компании — те, что часто подвергаются атакам хакеров, и те, которые сильно зависят от работы ИТ‑систем. В последнем случае аварийная ситуация генерирует убытки уже с первых секунд, и потери только усиливаются со временем.
Рассмотрим кейс сети магазинов Colin’s, для которой мы готовили DRP. Это поможет оценить пользу плана на практике. Сперва мы посчитали потенциальные риски. Компания управляет более чем 200 магазинами, распределительным складом, онлайн‑продажами и сотнями VPN‑подключений — поэтому даже короткий простой приводит к значительным убыткам. Расчёты показали, что каждый час полной недоступности мог обойтись примерно в 3–6 миллионов рублей.
После оценки мы установили целевые показатели восстановления (RTO и RPO) и подготовили сценарий аварийного переключения на резервную площадку. Когда у основного облачного провайдера действительно произошёл сбой, компания активировала DRP и в течение часа запустила инфраструктуру на платформе OXYGEN. Провайдер восстановил работу только через четыре часа.
В результате DRP позволил сократить простой примерно на три часа и избежать потенциальных потерь. Они бы составили 9‑20 миллионов рублей. После второго подобного случая компания полностью перенесла инфраструктуру в отказоустойчивое геораспределённое облако OXYGEN.


Из чего состоит Disaster Recovery Plan
План аварийного восстановления готовят в несколько этапов. Глобально всю работу можно разделить на оценку инфраструктуры и проработку сценариев реагирования. В общих чертах составление DRP в ИБ проходит так.
Оценка рисков и областей применения. Специалисты определяют наиболее важные ИТ‑активы: серверы, базы данных, рабочие станции сотрудников и другие объекты. Команда внедрения описывает все элементы инфраструктуры, которые потенциально могут выйти из строя.
Все сервисы классифицируют по критичности их влияния на бизнес и урону от возможных потерь. Обычно присваивают один из трёх классов:
- Категория A — критические, их нужно восстанавливать как можно скорее.
- Категория B — важные, с возможностью восстановления в течение бизнес‑дня.
- Категория C — допускают отложенное восстановление.
Для каждого аварийного события суммируют возможный ущерб и вероятность возникновения. На их основе выводят индекс или балльную оценку, но чаще — измеряют в денежных потерях.
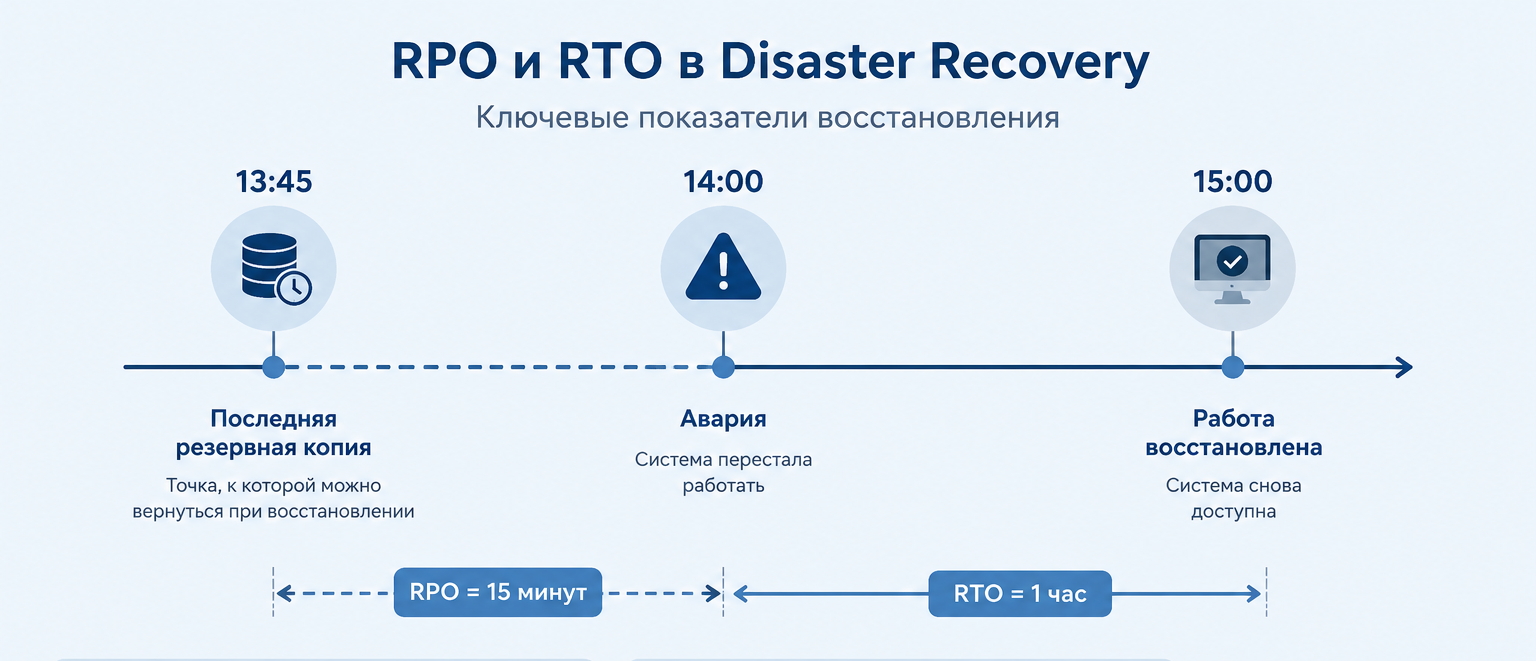
Определение целевых показателей. Главные значения DRP в ИТ — это RPO и RTO. Обычно по ним определяют эффективность всей системы восстановления:
- Recovery Point Objective — точка восстановления данных. Она определяет, как часто компания выгружает копии и какой максимально допустимый объем данных готов потерять бизнес. Например, если бэкапы происходят каждые 15 минут, значит максимум потерь — информация, которая за эти 15 минут могла накопиться.
- Recovery Time Objective — целевое время восстановления. Оно определяет, за какое время необходимо устранить аварию. Например, если RTO равняется 60 минутам, значит поломку необходимо устранить не позднее, чем за час.
Подготовка порядка бэкапов. В зависимости от типа сервисов, данные нужно выгружать в разном объёме — если выгружать всё подряд, компания переплатит за излишнюю тревожность. Поэтому данные разделяют по их ценности и копируют одним из трёх способов.
После выбора способа копирования, для данных определяют глубину хранения — то, сколько времени будут храниться копии. Обычно на короткий срок сохраняют менее важные или динамично меняющиеся данные, а критически ценную информацию держат на серверах значительно дольше.
Когда мы разрабатываем DRP для клиента, пользуемся правилом правилом 3‑2-1 резервного копирования. Расшифровывается оно так:
- Минимум 3 копии: оригинал (рабочие данные), первая и вторая резервная копии.
- Минимум 2 разных типа носителей: копии хранятся на разных типах устройств, чтобы поломка не уничтожила все данные. Например, сервер + внешний NAS или локальный диск + облачное хранилище.
- Минимум 1 копия вне основной площадки: дубликат системы должен быть географически удалён от основного места хранения. Например, в другом дата‑центре, во втором офисе или в облаке.
Учёт особенностей технической архитектуры. На этом этапе прорабатывают место хранения данных: второй дата‑центр, облачная инфраструктура или гибридная схема, когда часть хранится локально, а другая часть — в облаке. Также предусматривают сетевые решения, чтобы переключение проходило быстро.
Обычно все решения подчиняют двум схемам: Active‑Active или Active‑Passive. DRP разрабатывают под второй сценарий:
- Active‑Active — когда две аналогичные системы одновременно работают и обрабатывают запросы. При сбое одного сервера второй продолжает обслуживать пользователей.
- Active‑Passive — в штатном режиме работает только основной сервер, а резервный находится в режиме ожидания. При сбое основного сервера резервный переключается в активный режим. Переключение происходит по сценарию, который описан в DRP.
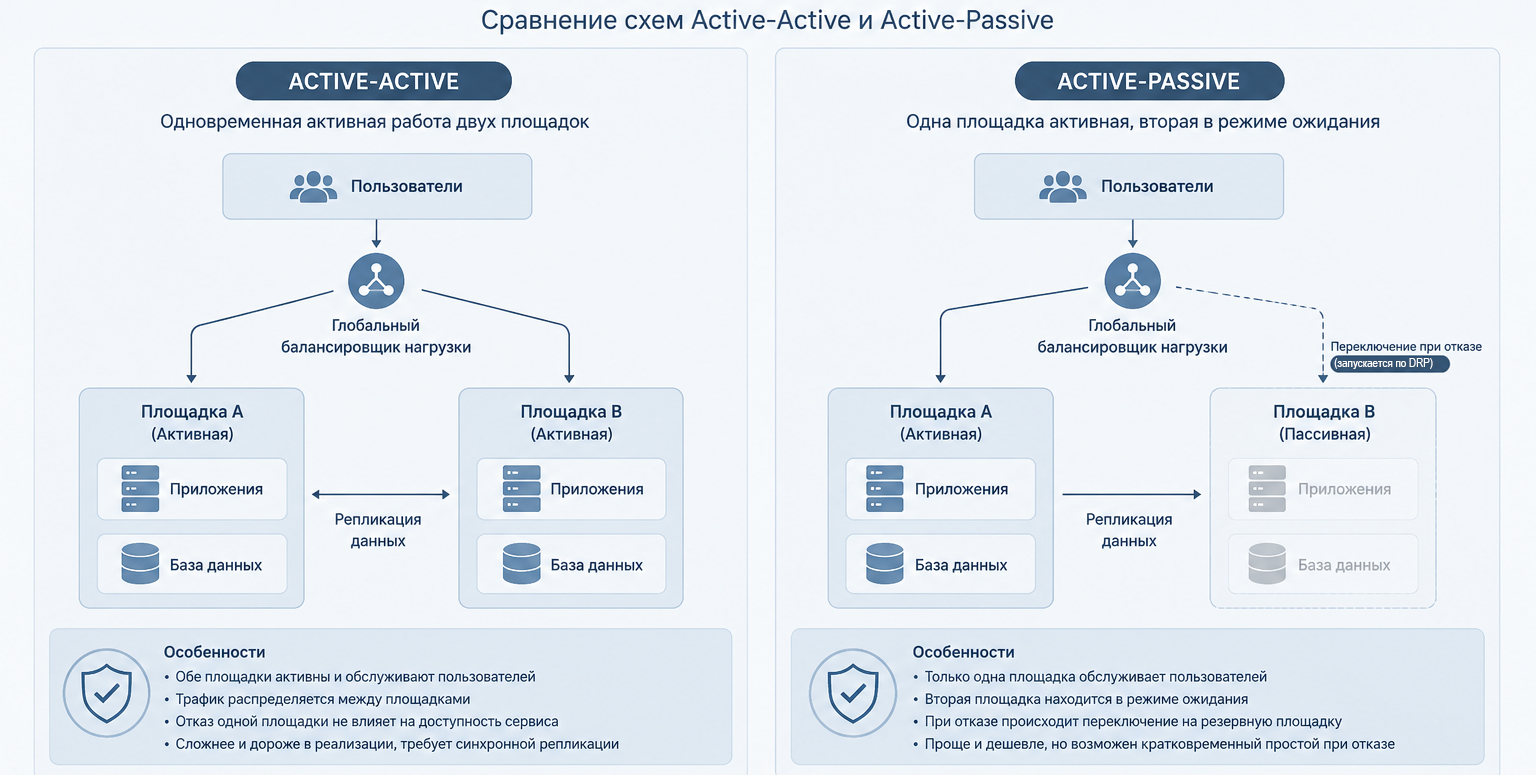
Disaster Recovery Plan описывает, при каких условиях происходит переключение на резервную систему. Когда возникает авария, специалисты инициируют протокол восстановления — копии системы запускаются в резервном хранилище.
DRP не ограничивается только техническими правилами — это в том числе и порядок работы команды. Когда возникает проблема, у всех сотрудников есть чёткий план действий: к кому обратиться, как оповестить клиентов, что предпринять для восстановления работы.
Как выбрать подрядчика для Disaster Recovery Plan
Для начала стоит проконсультироваться со специалистом по кибербезопасности. Он поможет определить, какое решение потребуется для вашей ИТ‑инфраструктуры. Если оценку проводит штатный специалист, стоит обратить на несколько параметров.
Возможные показатели RTO и RPO, который может обеспечить вендор. Чем они меньше, тем лучше. Хороший показатель — если сумма RTO и RPO не превышает одного часа.
Технические возможности поставщика. Хорошие признаки: наличие нескольких Tier III или Tier IV дата‑центров в разных регионах, гарантии бесперебойности питания и интернет‑соединения.
Сертификаты соответствия компании. Отличный набор для работы с ИБ: ISO 27001, ISO 22301, SOC 2 или аналогичные региональные сертификаты для работы с информационной безопасностью и данными.
SLA в договоре. Это гарантия отказоустойчивости сервиса — показатель измеряется во времени бесперебойной работы системы. Чем больше SLA, тем лучше: например, если он равен 99,982%, значит услуга будет недоступна только 0,018% времени, это 7 минут 53 секунды в месяц.
Сравнивайте разные решения: лучшими из них будут те, что совмещают несколько преимуществ. Чтобы провести точную оценку и подобрать оптимальное решение, стоит обратиться к вендору DRP‑услуг: он подскажет, какой способ будет наиболее надёжным и выгодным для вашего бизнеса.











